画像の文字をOCR技術で出力する。
OCR(Optical Character Recognition)、日本語で「光学文字認識」と呼ばれる技術は、手書きの文字や印刷された書類の活字をスキャナーやカメラなどで画像化し、その画像の文字を認識して、テキストのデジタルデータへと変換する技術のことをいいます。
ビジネスや日常生活でデジタル化が進む現代で、書類や書籍など印刷されたアナログ情報をデータ化するニーズが高まっていて、OCRの需要が今後さらに拡大していきます。
筆者がPythonでOCRを使い始めたのは、大学の講義資料を撮影して、その文字をテキストとして取り出したかったからです。
本記事では、Pythonを使って、画像の文字を認識する方法を紹介します。
- Pythonを使う人
- OCRに興味がある人
- Tesseractのインストールをしたい人
- Pythonで画像から文字認識をしたい人
- 業務を効率化したい人
Tesseract
Tesseractは、ヒューレット・パッカード(HP)が開発し、2006年から2017年まではGoogleが開発を進めた光学式文字認識エンジンです。現在はコミュニティが開発を続けていて、2026年10月時点の最新版は5.5系です。
Windows、Linux、macOSなどのオペレーティングシステムで利用できます。
Tesseractは、多数の言語に対応しており、日本語も使用可能なOCR機能です。
Tesseractのインストール(windowsの場合)
Tesseractはコマンドプロンプトでインストールするのではなく、外部からexeファイルをインストールする必要があります。
「Tesseract at UB Mannheim-GitHub」にアクセスをして、
最新版のパッケージ(2026年10月時点は5.5.3)をインストールしてください。
ダウンロードしたインストーラーの指示に従い、インストールをします。
※画像は、2023年時点で最新のライセンスの確認です。一部違うことがあります。
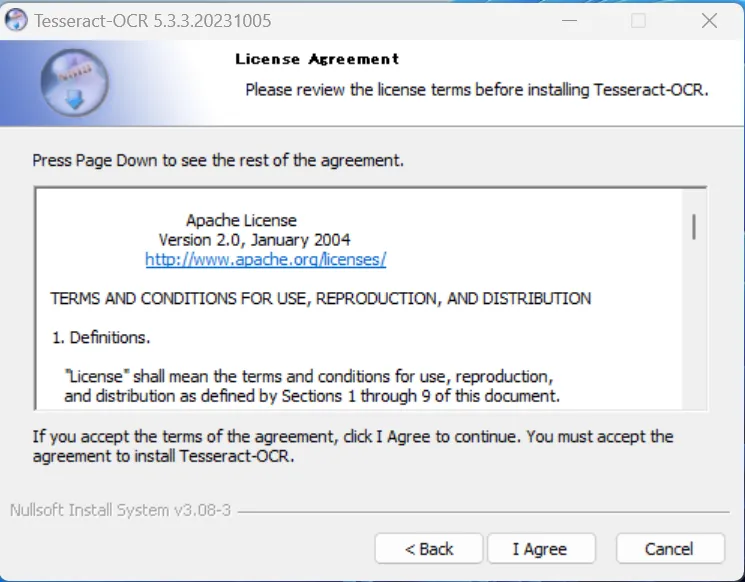
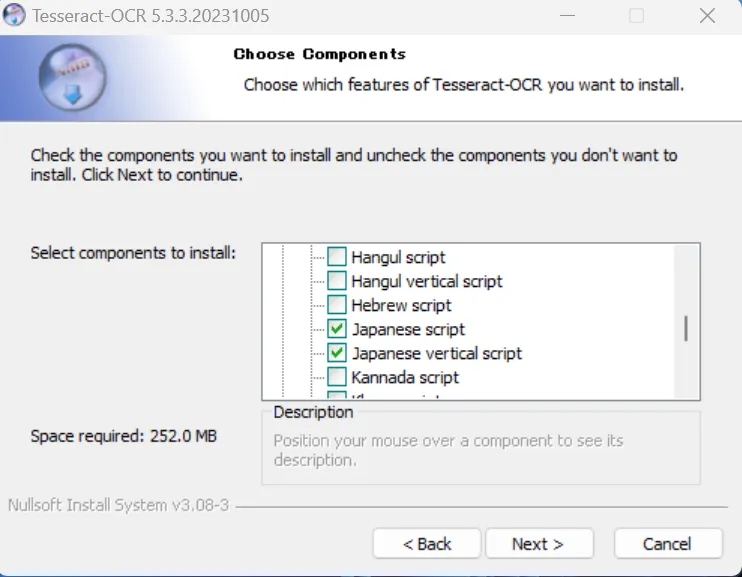
「Next」・「I agree」を進めていき、「Choose Components」までたどり着いたら、
ここから操作が必要です。
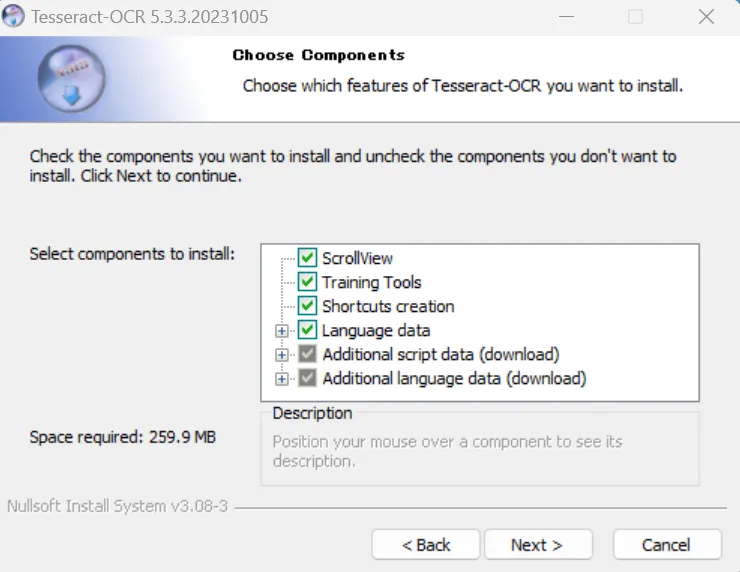
「Additional script data (download)」の「+」を押して展開してください。
項目の中から日本語(Japanese~)にチェックを入れてください。
これにより、tesseractのocr機能で日本語も文字認識できるようになります。
同様に「Additional language data (download)」項目の中から、日本語(Japanese~)にチェックを入れてください。
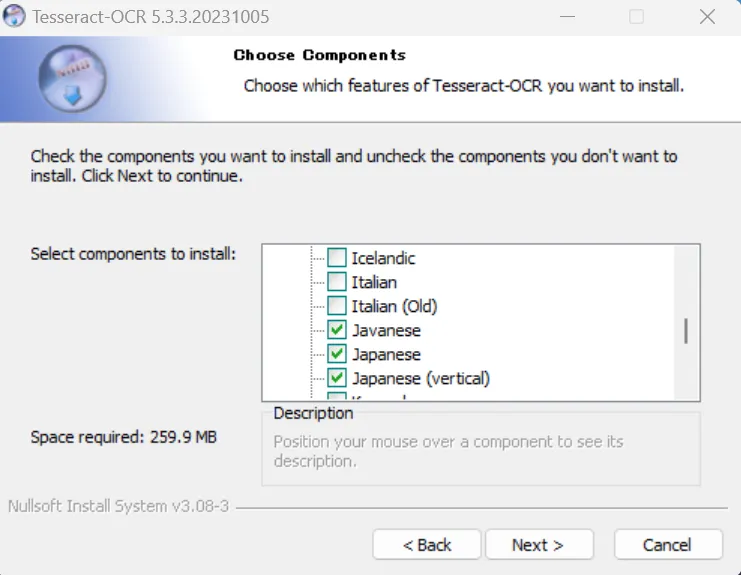
これらが完了したら、次に進み、インストールを完了させてください。
インストールできたら、コマンドプロンプトで次のコマンドを実行します。一覧に「jpn」が出ていれば、日本語の準備は完了です。
"C:\Program Files\Tesseract-OCR\tesseract.exe" --list-langs「jpn」が出ないときは、日本語のチェックを入れ忘れています。インストーラーをもう一度実行して、日本語にチェックを入れてください。
MacでTesseractをインストール
macの場合は、Homebrewを使用してTesseractをインストールすることができます。
brew install tesseract日本語も認識させるには、言語データもインストールします。
brew install tesseract-langWindowsでは、exeファイルをインストールしなければいけませんでしたが、Macの場合は、たったのこれだけです。
クリエイターのMac離れを言われていますが、OCRは、Macの方が手際よくできそうです。
Tesseractは商用利用可能か
Tesseract OCR は、Apache License 2.0 の下で公開されているオープンソースであるため、商用利用が可能です。
Apache License 2.0は、ソフトウェアを自由に使用、改変、配布することが許可されており、商用利用も含まれます。
ただし、Tesseractを組み込んだソフトを配布するときは、ライセンス本文と著作権表示を同梱する必要があります。ソースコードを公開する義務はありません。
日本語などの学習データ(traineddata)も、公式のものはApache License 2.0で公開されています。
ビジネスで使用する際は、必ずライセンスを一読し詳細をご確認ください。
C#のOCRでもTesseractが有効
Pythonだけではなく、C#でもOCR機能が使うことができます。C#はWindowsのデスクトップアプリを作成するときに使う言語であるためC#とOCR機能はとても相性が良いです。
Tesseractを開発PCにインストールしてあれば、Visual StudioでNuGetパッケージをインストールすることでC#のOCR機能が導入できます。
PyOCR
Tesseractをインストールしたので使用しているPCで、紙に印刷された文字をPCに起こすことができるようになりました。
次に、PythonでOCRを起動させるようにPyOCRを使えるようにします。
TesseractはPython専用ではないため、Pythonコードで動作させるパッケージが必要になります。
筆者がPyOCRを選んだのは、検索で上位に表示されていた記事がPyOCRを使っていたからで、特別な理由はありませんでした。
PyOCRは、OCRエンジンと統合するPythonラッパーライブラリであり、先ほどインストールしたTesseractをはじめ一般的なOCRエンジンと連携できます。
連携によってPyOCRを使用してさまざまなテキスト認識プロジェクトを実行できます。
PyOCRを使用するためには、OCRエンジンをインストールし、Pythonコードを使用して統合したOCRタスクを実行できます。
PyOCRはPillowのサポートによって、jpeg, png, gif, bmpなど様々な画像形式に対応しています。

Pythonでは、画像の形式(拡張子)を変更することができます。
PyOCRのインストール
ターミナルまたはコマンドプロンプトを開き、
以下のコマンドを実行してPyOCRをインストールします。
pip install pyocrPyOCRは商用利用可能か
PyOCRは、オープンソースのOCR(Optical Character Recognition)ライブラリですが、ライセンスはGPL v3以降(GPL v3+)です。Tesseract本体のApache License 2.0とは違うので注意してください。
GPLは商用利用そのものを禁止していませんが、使い方によって次の条件があります。
- 自分のPCや社内で使うだけ(ソフトを配布しない)なら、ソースコードを公開する義務は基本的にありません。
- PyOCRを組み込んだソフトを配布・販売する場合は、そのソフトもGPLで公開し、ソースコードを提供する必要があります。
- 責任免除: ライセンス提供者は、使用に伴う責任を負いません。ソフトウェアは「現状のまま」提供されます。
配布するアプリに組み込みたい場合は、Apache License 2.0のpytesseractを使う方法もあります。書き方は、後の「pytesseractで書く場合」で紹介します。
詳細は、公式サイトで各自確認してください。
Pythonで画像の文字を表示する
TesseractとPyocrの導入後、画像の文字の認識が可能になります。
ここでは、次の画像を使用します。
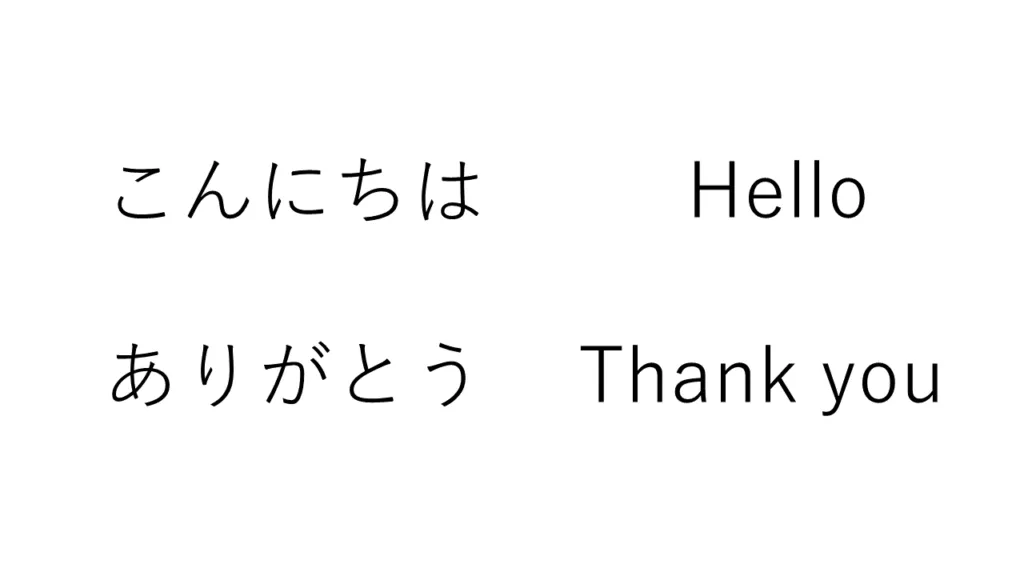
以下のコードはPythonを使用してOCRを実行し、指定した画像ファイルからテキストを抽出するためのものです。
ソースコード
import pyocr
from PIL import Image

#pyocrにTesseractを指定する。
pyocr.tesseract.TESSERACT_CMD = r'C:\Program Files\Tesseract-OCR\tesseract.exe'
tools = pyocr.get_available_tools()
tool = tools[0]

image =Image.open('test01.png')   #画像ファイルを読み込む
text = tool.image_to_string(image, lang="jpn", builder=pyocr.builders.TextBuilder())    #画像の文字を抽出

print(text) # 抽出したテキストを表示
解説
pyocrライブラリはPythonのOCRツールのラッパーライブラリで、
テキストを画像から抽出するために使用します。
PILライブラリはPython Imaging Libraryの略で、画像処理に使用します。
import pyocr
from PIL import Image
Tesseract OCRエンジンの実行ファイルのパスを指定し、Tesseractをコマンドラインから呼び出すために必要です。
また、pyocr.get_available_tools() を使用して、利用可能なOCRツールを取得、そのうちの最初のツールを選択しています。
一般的に、Tesseractが最初に利用可能なツールとしてリストに表示されます。
pyocr.tesseract.TESSERACT_CMD = r'C:\Program Files\Tesseract-OCR\tesseract.exe'
tools = pyocr.get_available_tools()
tool = tools[0]PILライブラリを使用し、指定されたファイルパスにある画像ファイル(’test01.png’)を開きます。
tool.image_to_string() メソッドを使用して、指定された画像からテキストを抽出します。
また、本メソッドの引数は、「image」、「lang」、「builder」です。
- image: OCRを実行する対象の画像。
- lang=”jpn”: OCRの言語設定。ここでは、日本語を指定しています。
- builder=pyocr.builders.TextBuilder(): 抽出されたテキストを加工するためのビルダーオブジェクトを指定しています。ここでは、テキストを生のテキストとして取得します。
最後に抽出されたテキストをコンソールに表示します。
image =Image.open('test01.png')   #画像ファイルを読み込む
text = tool.image_to_string(image, lang="jpn", builder=pyocr.builders.TextBuilder())    #画像の文字を抽出
実演
それでは、紹介したコードを実行します。
VScodeでスクリプトを実行すると冒頭のような処理ができます。
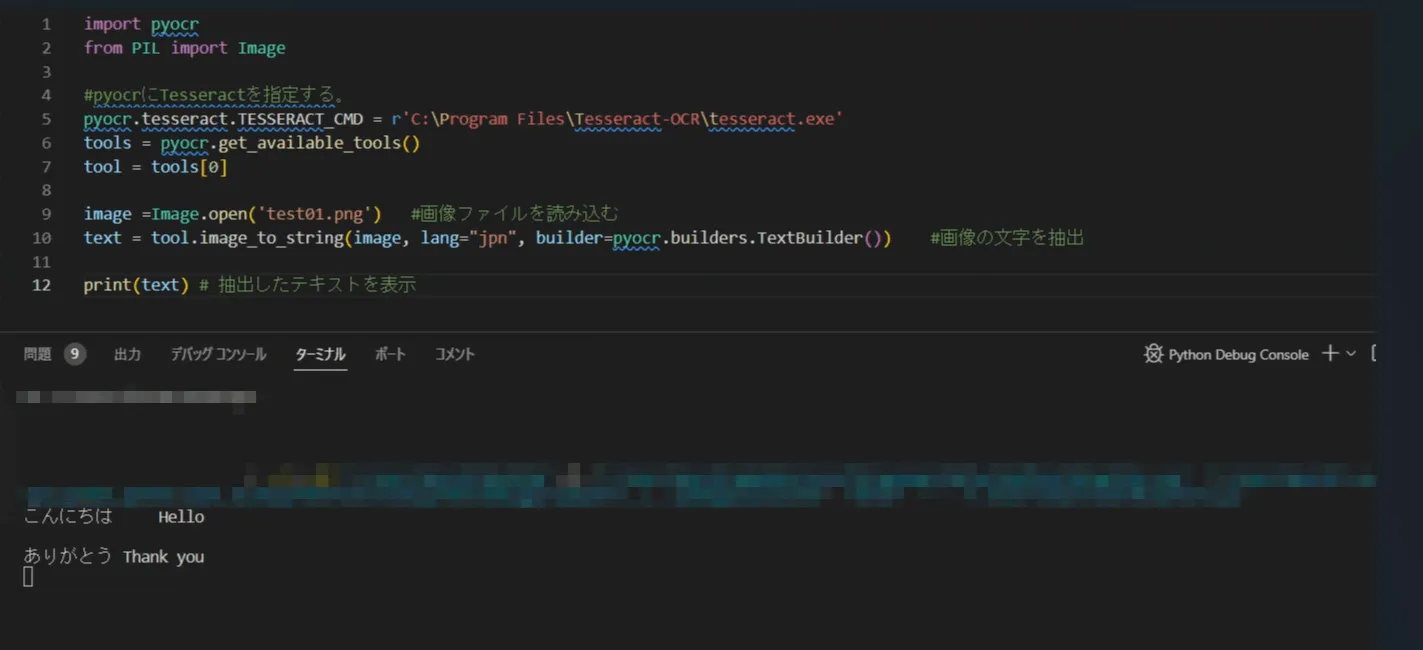
日本語で設定していましたが、ローマ字もしっかりと認識できるので、英語もコンソールに抽出されます。
pytesseractで書く場合
PyOCRの代わりに、pytesseractを使っても同じことができます。pytesseractはTesseract専用のPythonラッパーで、ライセンスはApache License 2.0です。配布するアプリに組み込むときや、使い方の情報を多く探したいときは、こちらが便利です。
pip install pytesseractimport pytesseract
from PIL import Image
#pytesseractにTesseractの場所を指定する。
pytesseract.pytesseract.tesseract_cmd = r'C:\Program Files\Tesseract-OCR\tesseract.exe'
image = Image.open('test01.png') #画像ファイルを読み込む
text = pytesseract.image_to_string(image, lang="jpn+eng") #日本語と英語を同時に認識する
print(text)lang=”jpn+eng” のように「+」でつなぐと、日本語と英語を同時に認識できます。Macでは、Tesseractの場所を指定する行は不要です。
pythonのocr機能を高精度にしたい
今回の実行では、日本語と英語をしっかりと認識することができました。しかし、文字認識が間違いだらけになってしまうことも多々あります。
筆者の場合、うまく読み取れなかったのは小さい文字や解像度の低い画像でした。
可能な限り正しく文字を出力するには、画像の質を上げることが最も身近で「解像度を上げる」、「ノイズを除去」する必要があります。
次のコードは、ノイズ除去とリサイズをしてOCRの精度を向上させるコードです。
追加で二値化処理(画像を白と黒に変換する技術)を行うことでより一層文字認識を正確にしています。
画像の加工にはOpenCVを使うので、先にインストールしてください。
pip install opencv-pythonimport cv2
import pyocr
from PIL import Image
pyocr.tesseract.TESSERACT_CMD = r'C:\Program Files\Tesseract-OCR\tesseract.exe'
tool = pyocr.get_available_tools()[0]
# OpenCVで画像を読み込み(グレースケール化)
img = cv2.imread("input_image.png", cv2.IMREAD_GRAYSCALE)
# 解像度アップ(リサイズ)
scale_factor = 2 # 2倍に拡大
height, width = img.shape
img = cv2.resize(img, (width * scale_factor, height * scale_factor), interpolation=cv2.INTER_CUBIC)
# ノイズ除去(中央値フィルター)
img = cv2.medianBlur(img, 3) # 小さなノイズを除去
# 二値化処理(OCRの精度が上がる)
_, img = cv2.threshold(img, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
# 加工した画像をそのままOCRにかける
text = tool.image_to_string(Image.fromarray(img), lang="jpn", builder=pyocr.builders.TextBuilder(tesseract_layout=6))
print(text)最後の行の「tesseract_layout=6」は、画像をひとまとまりの文章として読む指定です(Tesseractの –psm 6 にあたります)。文字の並び方によって結果が変わるので、うまく読めないときは数字を変えて試してください。
それでも精度が足りないときは、学習データを精度重視の「tessdata_best」の jpn.traineddata に入れ替える方法や、EasyOCR・PaddleOCRなど別のOCRライブラリを試す方法もあります。
pdfファイルをOCRする方法
PDFファイルは、Wordのような文書作成ツールであれば文字をコピーできますが、スキャンした画像をPDF化したファイルであると文字のコピーはできません。
画像だけのPDFを「検索可能なPDF」に変換するには、OCRmyPDFを使うことが非常に効果的です。1ページだけではなく複数ページ対応しており、Tesseractと連携で日本語を含む多言語を認識できます。
書類スキャンPDFをテキスト検索可能にしたい人、電子書籍の画像PDFにOCRをかけたい人、プログラムで定期的にOCRを自動処理したい人などにおすすめなパッケージです。
まとめ
OCR(光学文字認識)は、画像の文字を認識して、テキストのデジタルデータへと変換する技術のことをいいます。
書類や書籍などアナログ情報をデータ化するニーズが高まっていて、OCRの需要は拡大していきます。
自分のPCでOCRを使用するには、ヒューレット・パッカード(HP)が開発し、現在はコミュニティが開発を続けている光学式文字認識エンジンTesseractのインストールが必要です。
Windowsの場合は、exeファイル。Macの場合は、Homebrewを使用してTesseractを導入します。
また、Pythonで使う場合は、OCRエンジンと統合するPythonラッパーライブラリPyOCRのインストールが必要です。PyOCRはGPL v3+なので、配布するアプリに組み込むときはApache License 2.0のpytesseractも検討してください。